O RTK diz que corta 40% dos tokens. Conferi comando por comando
Todo comando que meu agente roda devolve texto, e esse texto vira token. Um ls -la numa pasta grande, um git log comprido, uma busca com centenas de linhas: tudo isso entra no contexto do agente, ocupa espaço e conta na franquia do plano. Em algum momento comecei a me perguntar quanto desse texto ele realmente precisa ler.
O RTK (Rust Token Killer) promete reduzir esse volume. É um binário único que fica entre o agente e o terminal: um hook reescreve o comando antes de ele rodar (git status vira rtk git status) e o agente recebe a saída filtrada e resumida. Uso há cerca de três meses, e o próprio RTK mantém um contador do que economizou.
O problema de confiar num contador é que quem mede é quem se beneficia do número. Antes de repetir qualquer percentual, quis conferir por fora.
O que o contador diz
O rtk gain --project mostra o total da pasta em que estou. Lido em 1º de novembro, no repositório onde guardo minhas notas, num dos computadores onde trabalho nele:
- 4.297 comandos, de 4 de agosto a 1º de novembro (83 dias com uso);
- cerca de 1 milhão de tokens de entrada, dos quais 417,5 mil economizados: 40,2%;
- 82 saídas grandes ficaram fora da conta, as que passam de uns 30 mil caracteres.
No outro computador, que tem o histórico separado, o mesmo comando mostrou 608 comandos e 44,4%. O contador é por máquina, então os dois números convivem.
A taxa mensal do primeiro computador caiu ao longo do tempo: 50,2% em agosto (697 comandos), 43,3% em setembro (1.180), 35,6% em outubro (2.330). Não sei explicar a queda. Uma hipótese é que passei a rodar mais comandos de um tipo que o RTK filtra pouco, mas não testei isso.
A conferência
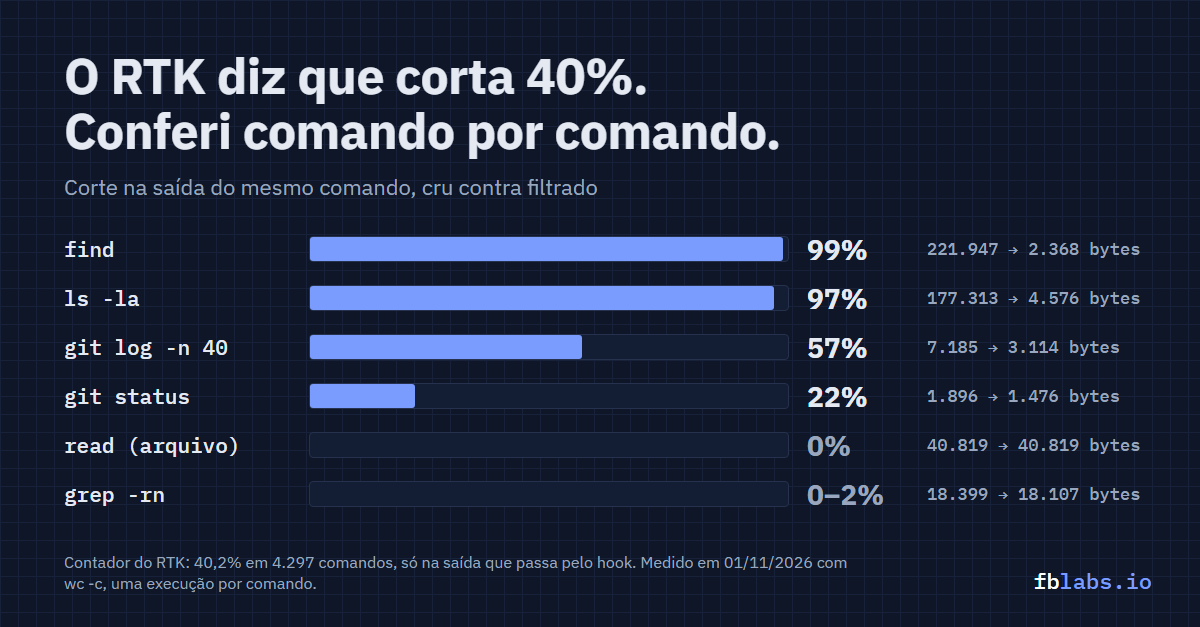
O teste é simples. Rodo o mesmo comando duas vezes, uma crua e outra via RTK, e comparo o tamanho da saída em bytes com wc -c. Bytes não são tokens, então a tabela mostra a ordem de grandeza, não o número exato de tokens. Cada comando rodou uma vez, na raiz do repositório.
| Comando | Cru | Via RTK | Corte |
|---|---|---|---|
ls -la numa pasta de capturas | 177.313 | 4.576 | 97% |
find <pasta> -name '*.md' | 221.947 | 2.368 | 99% |
git log -n 40 | 7.185 | 3.114 | 57% |
git status | 1.896 | 1.476 | 22% |
read de um arquivo de 40.819 bytes | 40.819 | 40.819 | 0% |
grep -rn em 3 pastas | 2.556 e 18.399 | 2.556 e 18.107 | 0% a 2% |
Repeti os mesmos comandos no outro computador, com outros arquivos e pastas. As proporções ficaram parecidas: ls -la perto de 97%, find perto de 97%, git log perto de 56%, read e grep em 0%. Os valores em bytes mudam porque as pastas são diferentes. A ordem entre os comandos não mudou.
O resultado é desigual. Em listagem de diretório o RTK corta quase tudo, e isso faz sentido: um ls -la de milhares de arquivos tem uma linha de permissão, dono e data pra cada um, e no meu uso o agente raramente precisa de tudo isso. No histórico do git o corte é de pouco mais da metade. Em git status é pequeno.
Em leitura de arquivo e em grep, nada. O rtk read no nível padrão devolve o conteúdo inteiro, como deve ser: se o agente pediu o arquivo, ele precisa do arquivo. Com -l minimal ou -l aggressive o corte foi de 1% (40.819 para 40.398 bytes). Provavelmente porque o grep já devolve só as linhas que casam, e sobra pouco pra tirar.
O que não consegui reproduzir
A tabela “By Command” do próprio rtk gain atribui a maior parte da economia ao rtk read: 93,6% e 12,7 milhões de tokens no histórico global, um valor maior que o total geral. No outro computador a tabela também aponta o read como a maior fatia (71,3 mil dos 77,9 mil tokens economizados no escopo do projeto), e a soma das linhas passa do total.
Meu teste mostra 0% no read. As duas coisas não cabem juntas, e não sei qual é a base de cálculo da tabela. Por isso não usei essa tabela em nenhum número deste texto. Também ignorei a “quota preservada”, que é uma estimativa do RTK com base num consumo fixo por janela de 5 horas do plano.
O que dá pra afirmar
Os 40,2% valem só para a saída dos comandos que passaram pelo hook. Não são 40% do consumo da sessão, que o contador não mede. “Economizei 40% da conta” seria falso.
A conferência sustenta menos que isso: em listagem e no histórico do git o filtro corta bastante, e em leitura e busca ele não mexe. Pelas amostras, é daí que vem a economia. Não medi o peso de cada comando no total, então não sei quanto cada tipo contribui de fato.
O que ainda não avaliei
Usei o RTK e medi o resultado. Não li o código nem avaliei o risco de deixar um hook reescrevendo cada comando que o agente roda. O repositório é Apache-2.0, e a pasta engine/ tem licença própria, a Business Source License 1.1. Não sei qual parte entra no binário que instalei. Também existe outro projeto chamado “rtk” (Rust Type Kit), e o README avisa pra conferir com rtk gain se você instalou o certo.
Por isso este texto relata uma medição e não recomenda instalar.
Como conferir no seu
rtk gain --project mostra o total da pasta atual. Pra conferir um comando, conte os bytes dos dois lados: ls -la | wc -c contra rtk ls -la | wc -c.
Com qualquer ferramenta que reporta o próprio ganho, comparo a saída crua com a filtrada antes de repetir o número do contador.
- harness-ia
- claude-code
- qualidade-de-dado